光互连

以光代电,为下一代数据中心与 AI 集群提供高带宽、
低延迟、低功耗的数据通路。
为什么需要光互连
打破带宽与距离的物理限制

单个感存算器件实现神经元;感存算阵列实现矩阵运算;感存算阵列部署神经网络算法。数据在感知端就地处理,无需搬运至云端,让具身智能设备更快、更省电、更可靠。

衰减低

长距离传输损耗远小于电信号

串扰小

多波长并行互不干扰

带宽更高

Gbps 到 Tbps 级传输速率

功耗更低

高速率下能耗显著下降

片间光互连

适配 CPU / GPU 的高性能片间光互连

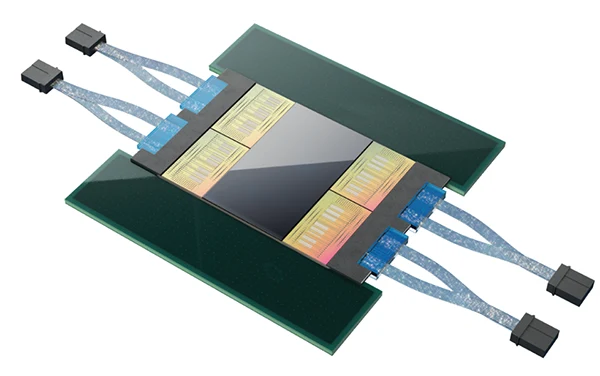
  • 通过光纤与光互连芯粒,实现 AI / CPU / GPU 芯粒间高速、低延迟的数据传输。
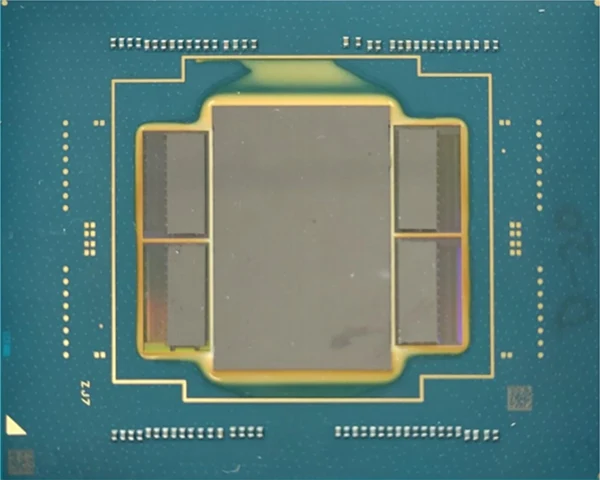
  • 封装级突破:将硅光引擎与计算芯粒共封装,在提升算力密度的同时大幅降低系统功耗与布线复杂度。
  • 片间光互连正成为下一代数据中心、AI 训练和推理等高性能应用的关键技术路径。
片上光互连
适配 CPU / GPU / HBM 的片上光互连

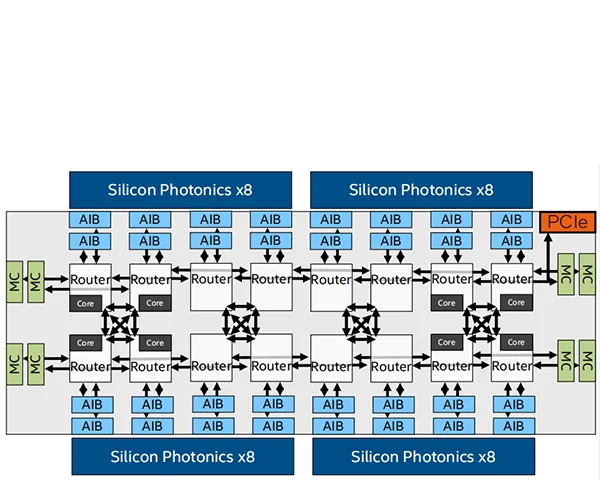
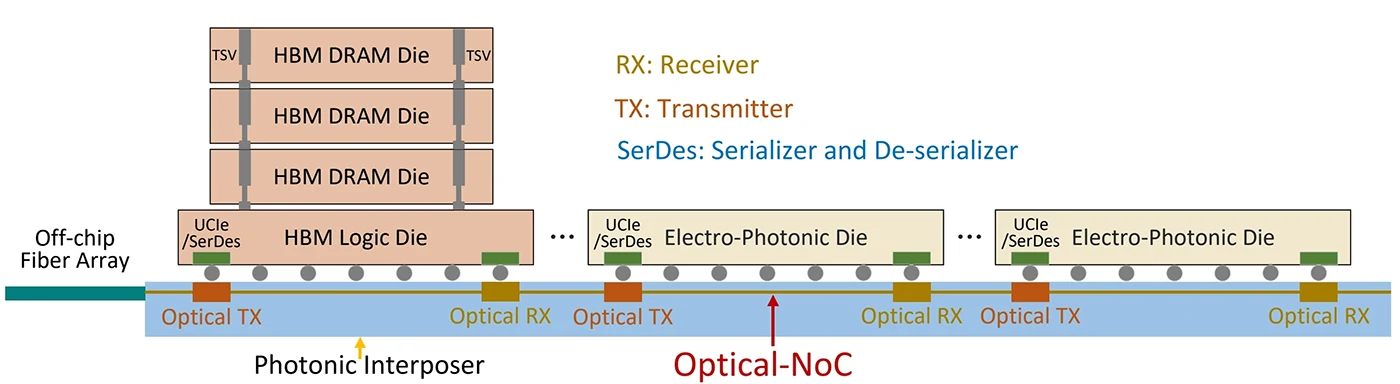
3D 立体封装 IC 的计算和存储密度更高,需要高带宽光互连方案。基于微环谐振器的片上光互连,提供一块大面积含光波导的基板:光器件面积小、集成度高、大规模集成潜力大。

自研光子中介层连接 HBM 与 CPU / GPU 芯粒
产品进度

HCM-LC2601 光互连 / 光计算芯片:版图已完成 → 2026–2027 多次流片验证 → 2028 量产

滚动至顶部